近年、生成AIやAIエージェントの普及が進み、企業に大きな価値をもたらしています。
一方で、「生成AIやAIエージェントで問題が起きたとき、何を止め、誰に連絡し、どのように復旧すればよいのか分からない」と不安を感じている企業担当者も多いのではないでしょうか。
AIを本番導入すると、検討すべき問題は「AIをどう活用するか」だけではありません。誤った案内、機密情報を含む回答、外部ツールの無許可操作、RAGの参照データ汚染などが発生した際に、業務への影響を広げずに止める仕組みが必要です。
本記事では、企業のDX、情報システム、セキュリティ、AI推進担当者に向けて、AIインシデント発生後の初動対応、重大度の判断方法、封じ込めから復旧までの手順を具体的に解説します。
目次
◇ AIインシデント対応とは
AIインシデント対応とは、AIシステムの動作や利用によって意図しない損害、権利侵害、情報漏えい、業務上のリスクが生じた際に、検知、封じ込め、原因除去、復旧、再発防止を行う活動です。
すべての誤回答を重大なインシデントとして扱う必要はありません。回答の誤りが顧客、従業員、取引、個人情報、法令対応などへ影響する可能性があるかを基準に判断します。
代表的な事象には、次のようなものがあります。
| 事象 | 想定される影響 | 初期の封じ込め例 |
|---|---|---|
| 顧客向けAIの誤案内 | 誤契約、顧客対応、信用低下 | 該当回答の停止、有人対応への切り替え |
| 機密情報・個人情報を含む回答 | 情報漏えい、法務・コンプライアンス対応 | 公開停止、権限・トークンの無効化 |
| プロンプトインジェクション | 指示の乗っ取り、不正な情報取得 | 入力元や外部ツールの一時遮断 |
| RAGの参照データ汚染 | 誤回答の継続、複数利用者への影響 | 問題データの検索対象からの除外 |
| AIエージェントの無許可実行 | 誤送信、誤更新、取引への影響 | 実行権限の停止、承認必須への変更 |
| API利用量の急増 | 予算超過、サービス負荷 | レート制限、長時間タスクの停止 |
2025年にはOWASPが生成AI向けのインシデント対応ガイドを公開し、GoogleやMicrosoftなどの大手テクノロジー企業が共同で立ち上げたCoSAIもAI資産、プロンプト、モデル推論、ツール実行、メモリ変更などを含む対応フレームワークを提示しました。こうした提言からは、AI事故への対応が個別製品の設定ではなく、組織的な運用課題になっていることが分かります。
(出典)OWASP GenAI Incident Response Guide 1.0
(出典)CoSAI AI Incident Response Framework
◇ AIインシデントが従来のシステム障害と異なる理由
まずAIを導入した企業が正しく認識すべきは、AIインシデントと従来のソフトウェア(非AIソフトウェア)のシステム障害では、その性質や対応が大きく異なるという点です。
◆ 出力が確率的で、一度の再現テストでは判断できない
従来のソフトウェアで何らかのシステム障害が発生した場合、同じ条件を再現して修正を確認できることがほとんどです。一方、生成AIは同じ質問をしても毎回同じ回答が返ってくるとは限りません。入力表現、会話履歴、参照データ、モデル更新などによって出力が変わります。
つまり、誤回答の修正後に同じ質問へ正しく回答しただけでは、復旧確認として不十分なのです。一度の入力だけでなく、言い換え、関連質問、悪意のある入力、異なる利用者権限を含むテストなど、多角的な検証が必要となります。
◆ 原因が複数の層にまたがる
多くの生成AIの回答やAIエージェントの実行結果は、基盤モデルだけで決まりません。システムプロンプト、RAG、会話メモリ、ガードレール、外部API、利用者権限などの要因が複雑に組み合わさっています。
そのため、誤回答や不具合が起きた際に「モデルの問題」と決めつけず、どの入力が、どのデータを参照し、どのツールを、どの権限で実行したかを追跡する必要があります。
◆ 深刻度が利用場面によって変わる
同じ誤回答でも、社内のアイデア出しと、医療、金融、採用、顧客契約に関する案内では影響の深刻度が異なります。件数だけでなく、対象業務・影響を受ける人・外部への公開範囲・AIが実行した操作などの実態から総合的に重大度を判断します。
Microsoftも、AIインシデントでは確率的な動作・状況に依存する深刻度・原因の曖昧さ・AI固有のテレメトリ不足を考慮する必要があると整理しています。
(出典)Microsoft「Respond to incidents in AI systems」
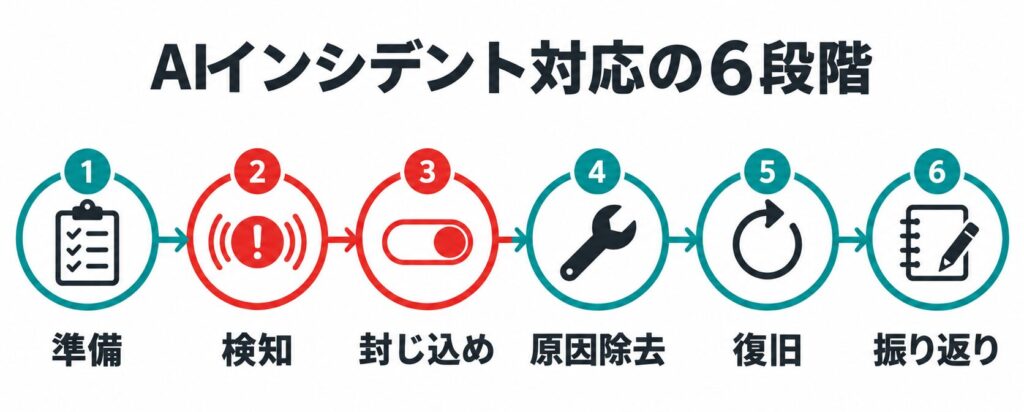
◇ AIインシデント対応の6段階
ここからは、AIインシデントに適切に対応するための準備から、復旧、振り返りまでを具体的に解説します。
1.準備:AI資産と停止方法を把握する
AIを導入したら最初に、社内で稼働するAIシステムを一覧化します。名称だけでなく、所有部門・管理者・利用者・接続データ・外部ツール・使用モデル・権限・ログの保存先・ベンダー窓口を記録しておきましょう。
特に重要なのがシステムの停止方法です。チャット画面の公開停止・外部ツール連携の無効化・APIキーの失効・RAGデータの除外・AIエージェントの実行停止を、担当者が迷わず実施できる状態にしておくことが重要です。
2.検知:利用者の報告とシステム監視を組み合わせる
AIの問題は、監視ツールより先に利用者が気付く場合があります。そのため、回答画面に報告導線を設け、問い合わせ窓口やヘルプデスクからAI運用担当へ連絡できるようにしておきましょう。
システム側では、エラー率だけでなく、拒否回答の急増・機密情報らしき出力・異常なツール実行・利用量の急増・低評価の集中・特定データへの参照偏りなどを監視し、管理者が把握できる仕組みを整えることが重要です。
3.封じ込め:原因が分かる前に影響を止める
インシデント発生時は、根本原因の特定を待たず、まず被害を広げる経路を止めます。AIシステム全体を停止する以外にも、問題のチャネルだけを閉じる・外部への書き込み権限だけを外す・特定のデータソースだけを検索対象外にするなど、段階的な封じ込めが可能です。
Microsoftは、最初の段階で問題の入力を遮断し、フィルターやアクセス制限を適用したうえで、24時間以内に類似パターンへ対策を広げる段階対応を示しています。
4.原因除去:モデル以外の構成要素も調べる
調査では、問題が発生した時刻・入力・出力・利用者・モデルバージョン・参照データ・検索結果・システムプロンプト・ツール呼び出し・権限変更などの履歴を時系列で確認します。
RAGの汚染であればデータの削除や再登録、プロンプトインジェクションであれば入力・参照元の制限、権限過多であれば最小権限への変更が必要です。モデル変更だけで解決しようとすると、インシデントの原因を残す可能性があります。
5.復旧:限定された範囲から段階的に再開する
復旧段階では、不具合が修正されたことではなく、システムが再開条件を満たしたことを確認します。検証時には代表質問・言い換え・境界条件・攻撃的入力・権限別のテストを行い、結果を記録します。
その後、社内担当者だけ・利用者の一部・読み取り専用といった限定的な条件下でシステムを再開します。一定期間の監視を経て問題が再発していないことを確認してから、対象を広げます。
問題の質問に正しく答えられたからといって即座に全面的に再開してしまうと、同じインシデントが別要因で繰り返される恐れがあります。
6.振り返り:個人を責めず、仕組みを改善する
振り返りでは、「誰がミスをしたか」ではなく、「なぜ検知や封じ込めが遅れたか」を確認しましょう。原因を特定し、今後の対策方針を策定した後、資産台帳・権限設定・ログ・テストデータ・連絡網・ベンダー契約の改善事項に落とし込みます。
米国国立標準技術研究所(NIST)が公開したガイドラインでも、インシデント対応を一時的な緊急作業ではなく、平時のサイバーリスク管理へ組み込むことを推奨しています。
(出典)NIST SP 800-61 Rev.3
◇ AIインシデントの重大度をどう判断するか
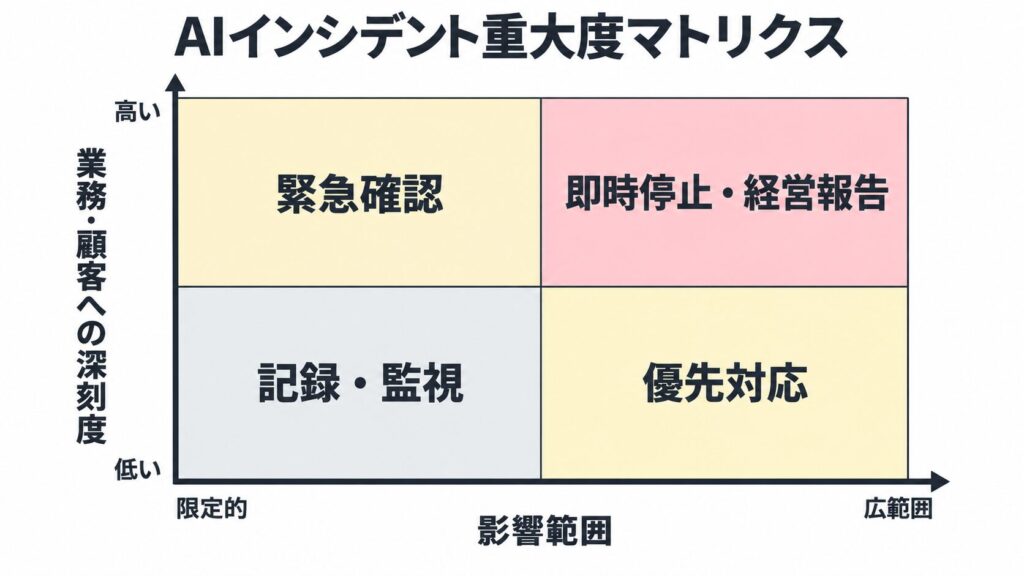
インシデントの重大度は、発生件数だけで決めないことが重要です。「影響範囲」と「業務・顧客への影響の深刻度」を基本軸にし、次の条件を加えて判断します。
- 個人情報・機密情報・認証情報が含まれるか
- AIが外部への送信・更新・購入などを実行したか
- 顧客・取引先・一般公開ページへ影響したか
- 医療・金融・人事など慎重な判断が必要な用途か
- 同じ問題が複数の利用者へ継続する可能性があるか
- 法務・広報・取引先への連絡が必要か
影響が限定的で深刻度も低い場合は、記録して監視を続けます。影響範囲は狭くても深刻な場合は緊急確認が必要です。広範囲かつ深刻な場合は、即時停止・経営報告・法務・セキュリティ部門との連携を検討します。
法令上の報告義務や顧客への通知要否は、事象・契約・業界によって異なります。実際の判断は、社内の法務・セキュリティ担当や、必要に応じて専門家へ確認してください。
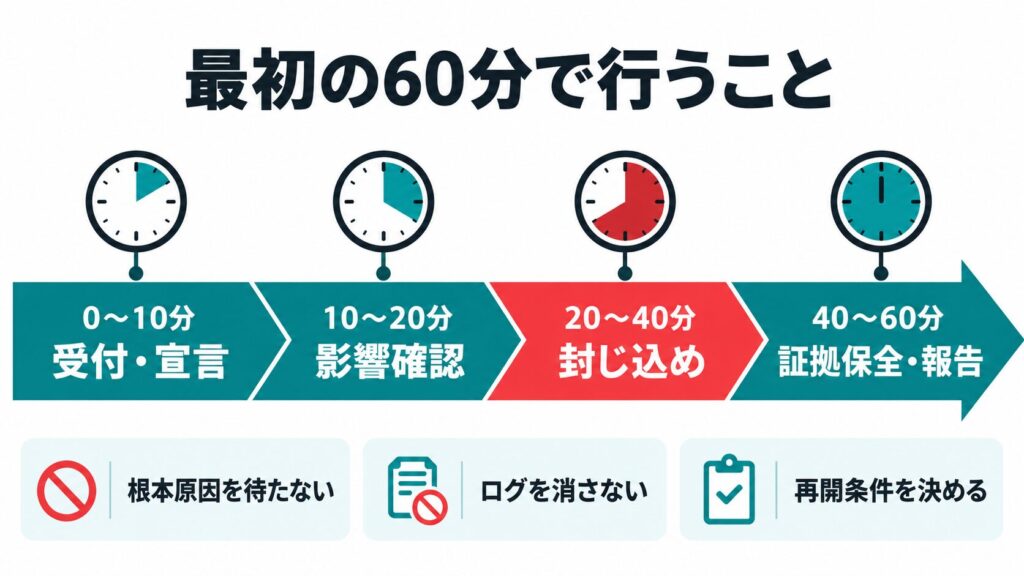
◇ AIインシデントの発生時、最初の60分で行うこと
ここからは、実際にAIインシデントが発生した際、担当者がパニックにならないように、最初の60分で実施すべき対応をまとめます。
▪️0〜10分:受付・宣言
まず、インシデントを認識したら、対象システム・発生時刻・報告者・確認できた事象を記録します。重大な可能性があればインシデントとして宣言し、対応責任者と連絡用チャンネルを決めます。
この段階で原因を断定する必要はありません。「確認済みの事実」「未確認の情報」「現在行っている対応」を分けて共有します。
▪️10〜20分:影響範囲の確認
システムの用途が「顧客向けか社内向けか」、「読み取りだけか外部操作を伴うか」、「機密情報を扱ったか」を確認します。接続されているRAG・クラウドストレージ・業務システム・外部APIも洗い出します。
▪️20〜40分:封じ込め
問題の経路を停止します。全面停止の判断に時間がかかる場合でも、公開チャネル・書き込み権限・問題のデータソース・該当するスキルやワークフローなど、停止できる単位から封じ込めます。
▪️40〜60分:証拠保全・報告
入力、出力、参照情報、ツール実行、権限、設定変更、時刻を保存します。詳細な調査前に会話履歴やデータを削除すると、原因の特定が難しくなってしまうので注意しましょう。
ただし、インシデントに関わる個人情報を過剰に記録することも避けなければなりません。インシデントが起こった際にどの情報を、いつまで保存し、誰が閲覧できるかを平時から決めておくことが重要です。
◇ AIインシデント対応プレイブックに必要な項目
企業が準備するインシデント対応のプレイブックには、少なくとも次の内容を含めます。
- 対象AIシステムと業務責任者
- 重大度の判定基準
- 利用チャネル、データ、外部ツールの停止方法
- ログと証拠の保存項目
- セキュリティ、法務、広報、事業部門の連絡先
- ベンダーへの連絡条件とSLA
- 復旧テストの質問セット
- 段階的な再開条件
- 顧客・従業員向けの連絡文案
- 振り返りと改善事項の管理方法
プレイブックは作成して終わりではありません。「RAGに誤った文書が登録された」「AIエージェントが許可されていない送信を行った」などのシナリオで机上演習を行い、担当者が実際に停止、確認、報告できるか検証します。
経済産業省のAI事業者ガイドラインでも、AIリスクを継続的に管理するためのチェックリストやワークシートが公開されています。自社のAI利用方針とインシデント対応を接続する際の参考になります。
(出典)経済産業省「AI事業者ガイドライン」
◇ AIツール選定時に確認したいインシデント対応機能
生成AIやAIエージェントを選ぶ際は、通常時の精度や使いやすさだけでなく、問題発生時の操作も確認します。
確認したいのは、利用者別のログ取得・回答根拠の表示・権限の分離・データソース単位の除外・モデル・設定の変更履歴・外部連携の停止・テストの一括実行・データ保持期間・ベンダーの緊急連絡窓口です。
ただ「ログを取得できる」というだけでは十分ではありません。入力・出力・参照元・ツール実行・設定変更のどこまで記録されるか、誰が閲覧できるか、どの形式で取り出せるかを確認しましょう。
◆ AIインシデント発生時に求められる機能
AIインシデントの対応には前述した6つの段階が重要です。ここでは、SELF株式会社の提供する統合AIサービス「SELFBOT」を例に、インシデント発生時に適切な対応を可能にする機能や特徴を紹介します。
◾️同じ画面で複数のBot・エージェントを管理可能
SELFBOTの管理画面では複数のBotやAIエージェントを構築し、管理できます。万が一インシデントが発生した場合は、Bot単位で即座に停止できるほか、リソース一覧画面ではAIが参照する情報を個別に「参照対象外」とすることができます。
◾️様々な条件で絞り込み・出力可能なログ
SELFBOTの「会話ログ」および「エージェントログ」画面では、Botの会話やエージェントの実行履歴を確認できます。日時・入力文・回答文・ユーザーID・チャネル種別・解決状況といった様々な条件で絞り込み、CSV形式で出力することができるため、インシデントの検出・調査時に役立ちます。
◾️復旧前の検証時に役立つ一括質問機能
SELFBOTには質問リストをCSVまたはExcelでアップロードし、一括で回答を実行する「一括質問機能」があります。本来は回答精度の改善に役立つ機能ですが、問題の修正後の回帰テストとしても利用できます。代表質問や類似質問を一覧化してアップロードすれば、多角的な検証作業を効率的に行うことができます。
これらの機能は、すべてノーコードで利用することができ、専門的な知識や技術は一切不要です。また、管理画面の問い合わせ窓口に報告することで、専任のCS担当者による迅速なサポートを受けることも可能です。
◇ 30日で備えるAIインシデント対応
AIインシデント対応の体制整備は、検討すべき項目が多く、一気に進めようとするとどこから手をつけていいかわからなくなりがちです。ここでは、AIインシデント発生時に落ち着いて対応できるよう、1ヶ月で整備できる対応手順の策定方法を紹介します。
1週目:AIシステムの一覧化
まずは、社内のAIシステム名称・管理者・接続先・権限を一覧化します。インシデント発生時に誰に報告し、何を止めればいいか、瞬時に判断できるようにしておきましょう。
2週目:停止手順とログ保全項目の策定
次に、チャネル・データ・外部ツールごとの停止手順を確認し、まとめておきましょう。インシデント発生時にはその重大度によって、停止する範囲や順序を判断することが重要です。
また、インシデントに関連するどの情報を保全する必要があるか、検討して整理しましょう。利用者の個人情報などを記録する場合には、保持期間や閲覧権限への配慮も必要です。
3週目:重大度判定・復旧テスト・社内外への連絡体制の整備
次に、重大度を判定する基準を定め、復旧テストの手順を策定します。また、想定される影響範囲に応じた社内外への連絡文案を作成しておきましょう。こういった準備を疎かにしていると、インシデント発生時に対応が遅れる大きな要因となります。
4週目:机上演習を行う
ここまでの準備が整ったら、机上演習を行い、停止までの時間・連絡漏れ・取得できなかったログ等を確認します。
最初から完璧な体制を目指す必要はありません。まずは、重要なAIシステムについて「誰が所有しているか」「どう止めるか」「何を残すか」「誰が再開を承認するか」の4点を明確にすることが、適切なAIインシデント対応の出発点です。
◾️インシデントに強いAIツール選定を
SELFBOTは使いやすい管理画面で複数のBot・エージェントを管理できます。引用情報まで確認可能な会話ログ、トラフィックデータの閲覧画面で異常の検出もしやすく、ユーザーからのフィードバック機能も備えています。
自社のナレッジや業務に合わせたAI導入と、運用・精度検証・インシデント対応を含む管理方法を検討している場合は、ぜひお気軽にご相談ください。


統合AIサービス「SELFBOT」を提供するSELF株式会社のマーケティングチーム。同社の専門分野であるRAGの技術や最新の市場状況を解説する記事をはじめ、AIエージェント、AIアバターなど同社サービスと関連の深い記事を発信しています。